RAG คืออะไร: หลักการ Retrieval-Augmented Generation และตัวอย่างระบบตอบคำถาม
อธิบาย RAG ตั้งแต่คลังเอกสาร การแบ่งข้อความ การค้นคืน ไปจนถึงการสร้างคำตอบ พร้อมตัวอย่างสมมติ เกณฑ์ประเมิน และเอกสารวิจัยต้นฉบับสำหรับรายงานโครงงาน
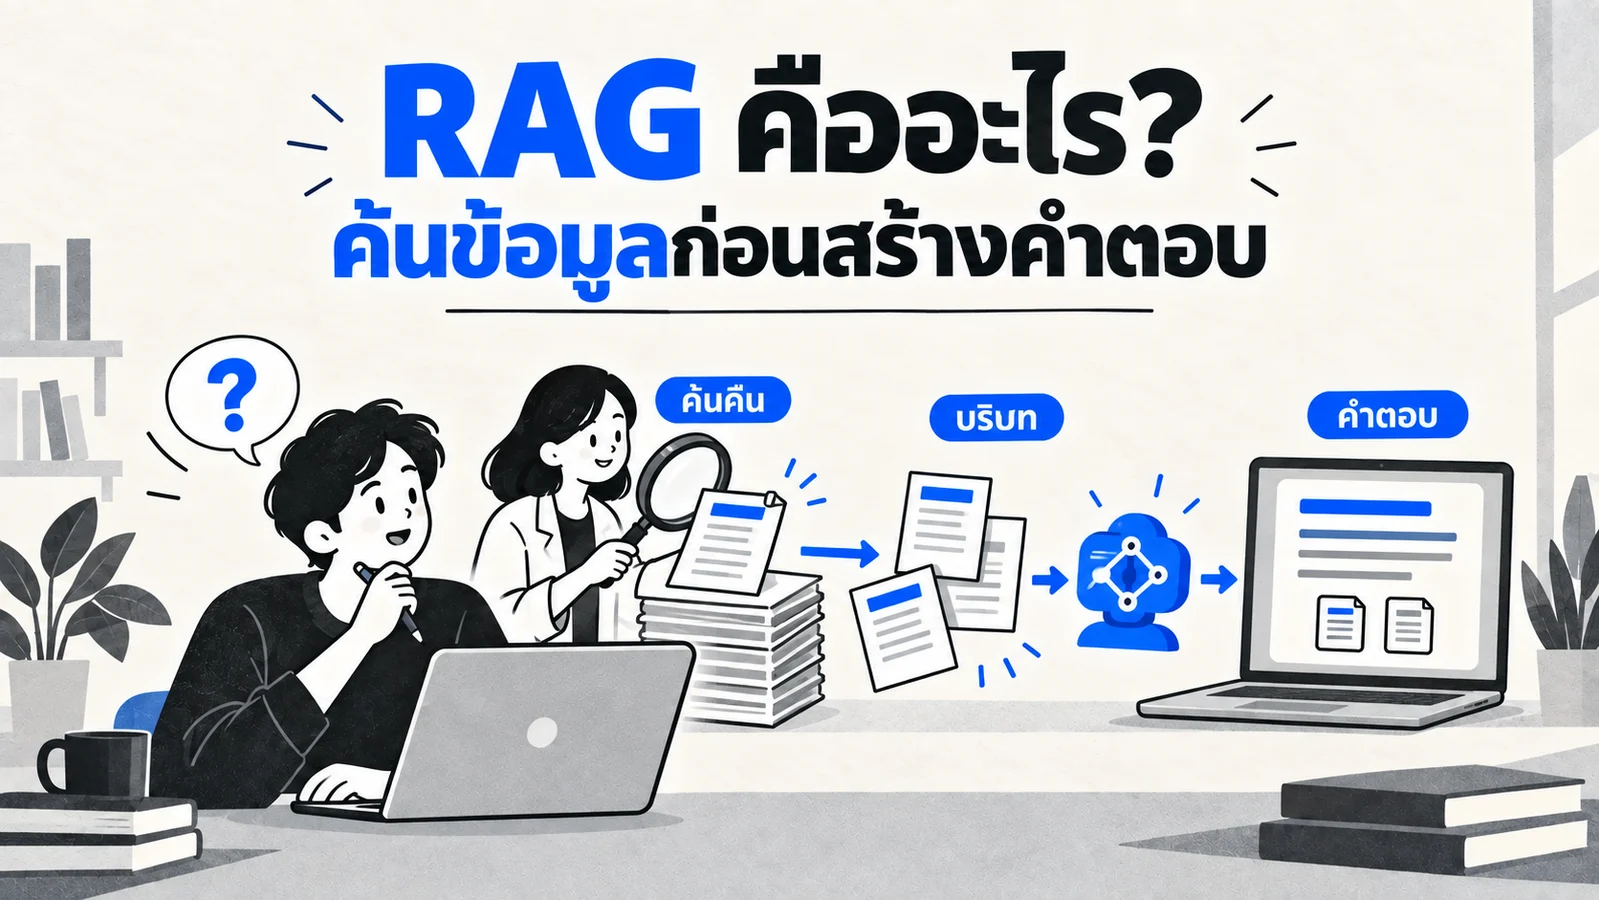
RAG ย่อมาจาก Retrieval-Augmented Generation เป็นแนวทางที่นำข้อมูลจากการค้นคืนมาใช้ประกอบการสร้างผลลัพธ์ด้วยโมเดลภาษา งานของ Lewis และคณะในปี 2020 ศึกษาการผสานความรู้ในพารามิเตอร์ของโมเดลกับแหล่งข้อมูลภายนอกที่ค้นคืนได้ โดยใช้ดัชนีเอกสารและโมเดลสร้างภาษาเป็นส่วนประกอบ [1]
สำหรับระบบตอบคำถามจากเอกสาร แนวคิดสำคัญคือค้นข้อความที่เกี่ยวข้องก่อน แล้วส่งข้อความนั้นพร้อมคำถามให้โมเดลใช้สร้างคำตอบ อย่างไรก็ตาม การมีเอกสารประกอบไม่ได้รับประกันว่าค้นถูกเอกสาร ตีความถูก หรืออ้างแหล่งข้อมูลได้ตรงทุกข้อความ จึงต้องประเมินแต่ละส่วนแยกกัน
ปัญหาที่ RAG ต้องการช่วยแก้
สมมติผู้ใช้ถามรายละเอียดในคู่มือของหน่วยงาน โมเดลภาษาอาจไม่ได้รับคู่มือฉบับนั้นในการฝึก หรือมีข้อมูลคนละรุ่น การอาศัยเฉพาะความรู้ในพารามิเตอร์จึงไม่ทำให้ทราบโดยอัตโนมัติว่าคำตอบอิงเอกสารปัจจุบันของหน่วยงานหรือไม่
RAG เปิดทางให้ระบบเลือกข้อมูลภายนอกมาเป็นบริบทขณะตอบ งานต้นฉบับของ Lewis และคณะใช้ตัวค้นคืนเชิงประสาทร่วมกับโมเดลแบบลำดับสู่ลำดับ และทดลองวิธีใช้ข้อความที่ค้นได้หลายรูปแบบ การทำระบบ “ค้นก่อนแล้วค่อยตอบ” ในโครงงานทั่วไปเป็นการประยุกต์แนวคิด ไม่ควรระบุว่าจำลองสถาปัตยกรรมหรือผลทดลองต้นฉบับครบถ้วนหากไม่ได้ทำเช่นนั้น [1]
RAG ยังแตกต่างจากการปรับพารามิเตอร์โมเดลด้วยการฝึกเพิ่มเติม ระบบอาจปรับคลังเอกสารและดัชนีโดยไม่ฝึกโมเดลสร้างคำตอบใหม่ แต่ต้องจัดการเวอร์ชันและการนำข้อมูลเข้าดัชนีให้ถูกต้อง หากยังไม่คุ้นกับโมเดลเชิงกำเนิด อ่านพื้นฐานใน Generative AI คืออะไร
ส่วนประกอบของระบบ RAG
ตัวอย่างโครงสร้างต่อไปนี้เป็นการสังเคราะห์เพื่ออธิบายระบบตอบคำถาม ไม่ได้กำหนดว่าโครงงานทุกแบบต้องใช้เทคโนโลยีหรือฐานข้อมูลชนิดเดียวกัน
- คลังเอกสารหรือ Corpus: ชุดข้อมูลที่อนุญาตให้นำมาตอบ พร้อมชื่อเอกสาร เวอร์ชัน วันที่มีผล และสิทธิ์ของผู้เข้าถึง
- หน่วยข้อความหรือ Chunk: ส่วนของเอกสารที่ใช้เป็นหน่วยค้นคืน ควรรักษาบริบทที่จำเป็น เช่น หัวข้อ เงื่อนไข และข้อยกเว้น
- ดัชนีและตัวค้นคืน: โครงสร้างที่ใช้เลือกข้อความที่เกี่ยวข้องกับคำถาม อาจค้นด้วยคำสำคัญ เวกเตอร์ หรือวิธีผสมตามโจทย์
- ตัวจัดบริบท: คัดข้อความ จัดลำดับ และแนบข้อมูลที่มาภายในขอบเขตที่โมเดลรับได้
- โมเดลสร้างคำตอบ: ใช้คำถามและบริบทสร้างคำอธิบาย โดยระบบต้องตรวจและแสดงที่มาของคำตอบให้ผู้ใช้พิจารณา
ภาพที่ 1: ภาพอธิบายที่ผู้เขียนจัดทำขึ้น แสดงลำดับงาน RAG โดยการมีแหล่งข้อมูลประกอบไม่ได้รับประกันความถูกต้องของคำตอบ
Embedding ช่วยค้นเอกสารอย่างไร
Embedding คือการแทนข้อมูลด้วยเวกเตอร์ตัวเลข ในบริบทการค้นคืน ระบบคำนวณตัวแทนของคำถามและข้อความ แล้วจัดอันดับตามค่าความสัมพันธ์ที่กำหนด งาน Dense Passage Retrieval ของ Karpukhin และคณะใช้ตัวเข้ารหัสสองส่วนสำหรับคำถามและข้อความ เพื่อเรียนรู้ตัวแทนที่ใช้ค้นข้อความสำหรับงานตอบคำถาม [2]
ความคล้ายของเวกเตอร์ไม่ได้หมายถึงความถูกต้องของข้อเท็จจริงหรือสิทธิ์เข้าถึงเอกสาร หากคำถามมีรหัสแบบฟอร์มเฉพาะ การค้นด้วยคำตรงอาจเป็นตัวเปรียบเทียบที่สำคัญ ขณะที่คำถามซึ่งใช้ถ้อยคำต่างจากคู่มืออาจต้องพิจารณาความสัมพันธ์ของข้อความเพิ่ม การเลือกวิธีควรทดลองกับคำถามของโครงงานเอง
ค่า k มักใช้ระบุจำนวนรายการที่เลือกกลับมา เช่น top-k แต่การเพิ่มจำนวนเอกสารไม่ได้ทำให้คำตอบดีขึ้นเสมอ ควรกำหนดวิธีประเมินว่าข้อความหลักฐานที่จำเป็นอยู่ในรายการที่ค้นได้หรือไม่ พร้อมบันทึกกรณีที่มีเอกสารคล้ายกันแต่ตอบคนละเงื่อนไข
การแบ่งข้อความและเลือกบริบทมีผลต่อคำตอบอย่างไร
ตัวอย่างเชิงออกแบบของผู้เขียนคือคู่มือที่ระบุว่า “ขอยกเลิกได้ก่อนวันนัด” และมีข้อยกเว้นในย่อหน้าถัดไป หากแบ่ง Chunk จนข้อความทั้งสองแยกกัน แล้วค้นได้เฉพาะประโยคแรก โมเดลอาจไม่ได้รับเงื่อนไขที่เปลี่ยนคำตอบ การเก็บหัวข้อและข้อความข้างเคียงจึงเป็นทางเลือกที่ควรนำไปทดลอง
ในอีกด้านหนึ่ง การส่งเอกสารทั้งหมดก็ไม่ใช่ข้อพิสูจน์ว่าโมเดลใช้ข้อมูลครบ งาน Lost in the Middle ของ Liu และคณะพบว่าตำแหน่งของหลักฐานในบริบทยาวมีผลต่อประสิทธิภาพของโมเดลที่ศึกษา โดยบางกรณีทำงานด้อยลงเมื่อข้อมูลสำคัญอยู่กลางบริบท ข้อค้นพบนี้ต้องอ่านภายใต้โมเดลและงานทดลองของงานวิจัย ไม่ควรตีความเป็นค่าประสิทธิภาพของทุกโมเดลในปัจจุบัน [3]
ข้อเสนอสำหรับโครงงานจึงเป็นการเปรียบเทียบขนาด Chunk การรักษาหัวข้อ จำนวนข้อความ และลำดับการส่งบริบท โดยเปลี่ยนปัจจัยเป็นระบบ แทนการเปลี่ยนทุกค่าในครั้งเดียวแล้วสรุปว่า RAG ดีขึ้น
ตัวอย่างสมมติ: ระบบตอบคำถามคู่มือยืมห้องประชุม
กรณีนี้เป็นตัวอย่างที่ผู้เขียนสังเคราะห์ ไม่ใช่นโยบายของมหาวิทยาลัยหรือองค์กรใด สมมติคลังเอกสารมีคู่มือการยืมห้อง รายการอุปกรณ์ และเงื่อนไขการยกเลิก โดยคู่มือฉบับปัจจุบันระบุว่าผู้ยืมต้องยืนยันรายการก่อนเวลาที่กำหนด และมีขั้นตอนแยกสำหรับการขออุปกรณ์เพิ่มเติม
เมื่อผู้ใช้ถามว่า “จองห้องแล้วขอเครื่องฉายเพิ่มได้ไหม” ระบบควรค้นข้อความเรื่องการเปลี่ยนรายละเอียดและอุปกรณ์ ไม่เลือกเพียงหน้าที่มีคำว่า “จองห้อง” จากนั้นส่งเงื่อนไขที่พบพร้อมรหัสเอกสารให้โมเดลร่างคำตอบ ผู้ใช้ควรเปิดอ่านย่อหน้าต้นทางได้จากหน้าผลลัพธ์
กำหนดกรณีตรวจอย่างน้อยสี่ประเภท ได้แก่ คำถามที่มีคำตอบตรงในเอกสาร คำถามที่ต้องเชื่อมสองหัวข้อ คำถามที่เอกสารให้ข้อมูลไม่ครบ และคำถามที่อ้างเงื่อนไขฉบับเก่า หากไม่มีข้อมูลค่าปรับอยู่ในคลัง ระบบควรแจ้งว่าหลักฐานไม่พอและส่งต่อช่องทางตรวจสอบ ไม่เติมตัวเลขขึ้นเอง
สำหรับการสาธิต ให้ใช้เอกสารสมมติที่ระบุเวอร์ชันและผู้จัดทำ พร้อมแสดงรายการข้อความที่ค้นได้ก่อนแสดงคำตอบ วิธีนี้ช่วยแยกว่าอาการตอบผิดเกิดจากไม่พบหลักฐาน หรือพบหลักฐานแล้วแต่สรุปผิด โดยยังไม่สรุปผลด้านประสิทธิภาพจนกว่าจะทดลองตามแผน
ประเมิน Retrieval และ Generation แยกกัน
กรอบประเมินต่อไปนี้เป็นข้อเสนอของผู้เขียนสำหรับกรณีศึกษาข้างต้น ควรกำหนดผู้ตรวจและนิยามข้อมูลที่ถือว่าถูกต้องก่อนทดลอง
- การค้นพบหลักฐาน: สำหรับคำถามที่มีคำตอบ ตรวจว่าข้อความหลักฐานที่ผู้ตรวจระบุไว้ถูกค้นกลับมาหรือไม่ หากใช้ Recall@k ให้ระบุหน่วยที่นับและชุดข้อความที่ถือว่าเกี่ยวข้องอย่างชัดเจน
- ความถูกต้องของคำตอบ: ตรวจเงื่อนไข ขั้นตอน และข้อยกเว้นที่คำตอบต้องรักษา ไม่ใช้ความคล่องของภาษาเป็นเกณฑ์แทนสาระ
- ความตรงของแหล่งอ้างอิง: ตรวจว่าทุกแหล่งที่แสดงมีอยู่จริง และข้อความในแหล่งนั้นรองรับข้อกล่าวอ้างที่ผูกอยู่ การแสดงลิงก์ได้ไม่เท่ากับอ้างถูก
- การงดตอบเมื่อหลักฐานไม่พอ: แยกการปฏิเสธที่เหมาะสมออกจากการไม่ตอบทั้งที่มีหลักฐาน ไม่ให้ระบบได้คะแนนดีเพราะงดตอบทุกคำถาม
- ภาระระบบ: วัดเวลาค้น เวลาสร้างคำตอบ ข้อผิดพลาด และค่าใช้บริการในเงื่อนไขการทดลองเดียวกัน
ควรมีวิธีฐานสำหรับเปรียบเทียบ เช่น แสดงผลค้นหาพร้อมข้อความต้นทางโดยยังไม่ใช้โมเดล หากผู้ใช้ทำงานสำเร็จจากผลค้นหาได้อยู่แล้ว การเพิ่มคำตอบที่สร้างใหม่ต้องแสดงประโยชน์เพิ่มเติมที่ตรวจได้ ไม่ใช่พิจารณาเพียงความน่าสนใจของรูปแบบแชต
ข้อจำกัดของระบบตอบคำถามจากเอกสาร
ในเชิงการออกแบบระบบ ผู้เขียนเสนอให้พิจารณาความครบของคลังเอกสาร การอัปเดตเวอร์ชัน และสิทธิ์ข้อมูลควบคู่กับคุณภาพคำตอบ เอกสารผิดหรือหมดอายุสามารถทำให้คำตอบอ้างแหล่งได้ครบแต่ยังไม่เหมาะกับสถานการณ์ปัจจุบัน
ข้อมูลที่ถูกลบหรือเปลี่ยนสิทธิ์ต้องมีผลต่อเส้นทางค้นคืนด้วย ไม่ควรให้โมเดลเห็นเนื้อหาที่ผู้ถามไม่มีสิทธิ์แล้วหวังให้ข้อความคำสั่งป้องกันการเปิดเผยภายหลัง เช่นเดียวกับคำสั่งที่อาจปรากฏในเอกสาร ควรถูกปฏิบัติเป็นข้อมูลของเอกสาร ไม่ใช่อำนาจเปลี่ยนสิทธิ์หรือสั่งงานระบบ
ข้อเสนอข้างต้นเป็นขอบเขตที่ต้องตรวจในแอปพลิเคชัน ไม่ใช่คุณสมบัติที่เกิดขึ้นอัตโนมัติจากการใช้เวกเตอร์หรือ RAG และยังต้องมีทางให้ผู้ใช้แจ้งคำตอบผิด อ่านต้นฉบับ หรือขอความช่วยเหลือเมื่อข้อมูลที่พบขัดกัน
การนำไปใช้ในรายงานโครงงาน
บททฤษฎีควรแยกหลักการสร้างภาษา การค้นคืน และการใช้บริบทยาว โดยอ้างเอกสาร [1]–[3] ตามประเด็นที่เอกสารแต่ละฉบับศึกษาจริง สำหรับบทวิธีดำเนินงาน ให้แสดงแหล่งข้อมูล ขั้นตอนเตรียมเอกสาร หน่วย Chunk วิธีค้น จำนวนรายการ และวิธีเชื่อมคำตอบกับแหล่งอ้างอิง
ระบุเวอร์ชันคลังเอกสาร โมเดล และค่าการทดลองที่เข้าถึงได้ แยกชุดคำถามสำหรับปรับระบบออกจากชุดประเมิน และจัดเก็บหลักฐานการค้นกับคำตอบเพื่อให้ตรวจย้อนหลังได้ หากรายงานตัวเลข ให้แสดงจำนวนตัวอย่าง ตัวหาร เกณฑ์ให้คะแนน และข้อจำกัดของชุดข้อมูล ไม่ถ่ายโอนตัวเลขจากงานวิจัยมาเป็นผลของโครงงานตนเอง
บทความนี้ใช้เป็นคำอธิบายและกรณีศึกษาประกอบได้ แต่หลักทฤษฎีควรอ่านและอ้างต้นฉบับโดยตรง ตัวอย่างอ้างอิงบทความนี้เมื่อเผยแพร่แล้วคือ: Waihaus Studio. (2026, 2 ตุลาคม). RAG คืออะไร: หลักการ Retrieval-Augmented Generation และตัวอย่างระบบตอบคำถาม. บทความบนเว็บไซต์ Waihaus ควรปรับรูปแบบตามข้อกำหนดของรายวิชาหรือสถาบัน
เมื่อนำแนวคิดไปพัฒนาระบบ อ่าน การพัฒนาแอปในยุค AI เพื่อพิจารณาการตรวจสอบและดูแลต่อ หรือดูบริบทงาน Web Application ที่ต้องเชื่อมข้อมูลและสิทธิ์กับการใช้งานจริง
เอกสารอ้างอิง
- [1] Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W.-t., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. arXiv:2005.11401. doi:10.48550/arXiv.2005.11401
- [2] Karpukhin, V., Oguz, B., Min, S., Lewis, P., Wu, L., Edunov, S., Chen, D., & Yih, W.-t. (2020). Dense Passage Retrieval for Open-Domain Question Answering. Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing (EMNLP), 6769–6781. Association for Computational Linguistics. doi:10.18653/v1/2020.emnlp-main.550
- [3] Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., & Liang, P. (2024). Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics, 12, 157–173. doi:10.1162/tacl_a_00638